
7 Schritte, um Kundenabwanderung mit KNIME vorherzusagen
Heute wissen wir, dass die Gewinnung eines neuen Kunden 6- bis 7-mal teurer ist als ihn zu halten. Aus diesem Grund ist eine der wichtigsten Aufgaben im Management eines Kundenportfolios die Kundenbindung.
Die Bedeutung der Kundenbindung
Die Datenanalyse zeigt, dass die Abwanderungsquote vor allem in den Branchen Telekommunikation, Presse und Energie besonders stark ausgeprägt ist. Dies liegt hauptsächlich an Geschäftsmodellen, die auf befristeten Verträgen oder Abonnements basieren. Außerdem wird geschätzt, dass 68 % der Kunden das Unternehmen wechseln, weil sie einen schlechten Service erhalten haben.
Heute ist die Kundenbindung dank Fortschritten in der Datenverarbeitung und der kontinuierlichen Erfassung von Tausenden Transaktionen deutlich effizienter. Tatsächlich zeigen einige Studien, dass eine Erhöhung der Kundenbindungsrate um nur 5 % die Gewinne um 25 % bis 95 % steigert und dass wachsende Unternehmen den Customer Success stärker priorisieren als Unternehmen, die stagnieren. Wir sollten die Informationen, die uns vorliegen, daher nutzen, um die Abwanderungsquote – auch Churn genannt – zu reduzieren, indem wir sie zunächst identifizieren, abwanderungsgefährdete Kunden nach Profil gruppieren und die Ursachen dieser Abkehr verstehen, um Handlungsprotokolle festzulegen und so den Verlust von Kunden zu vermeiden.
Wie binden wir also unsere Kunden?
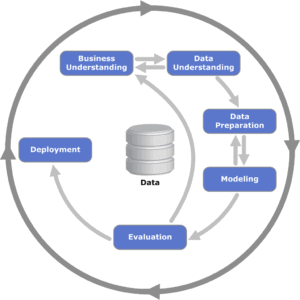
Die Antwort lautet: mit prädiktiven Algorithmen zur Kundenabwanderung. Dafür arbeiten wir mit der Methodik CRISP-DM (Cross-Industry Standard Process for Data Mining), die Ihrer Organisation durch einen hierarchischen Prozess aus mehreren Aufgaben die notwendige Struktur bietet, um in der Datenanalyse bessere und schnellere Ergebnisse zu erzielen.
- Geschäftsverständnis
- Datenverständnis
- Datenaufbereitung
- Modellierung
- Bewertung
- Implementierung bzw. Deployment
- Visualisierung
Um diesen gesamten Prozess durchzuführen, nutzen wir das Tool KNIME, das den vollständigen Data-Mining-Zyklus abdeckt. Dank der Möglichkeit, sich mit mehreren heterogenen Datenquellen zu verbinden, können wir Daten aus unterschiedlichen Datenbanken, Dateien und diversen Webservices wie Azure usw. mit sehr geringem Aufwand zusammenführen.
Mit einer großen Auswahl an Nodes für das Preprocessing bietet das Tool optimale Voraussetzungen für die Erstellung automatisierter ETL-Prozesse. Zudem stellt es die wichtigsten Algorithmen und Evaluationsmethoden zur Erstellung leistungsstarker Modelle bereit. Darüber hinaus verfügt es über zahlreiche Erweiterungen (Text Processing, Big Data mit Spark und Hadoop, Deep Learning mit TensorFlow und Keras und viele mehr), die das Tool noch leistungsfähiger machen.
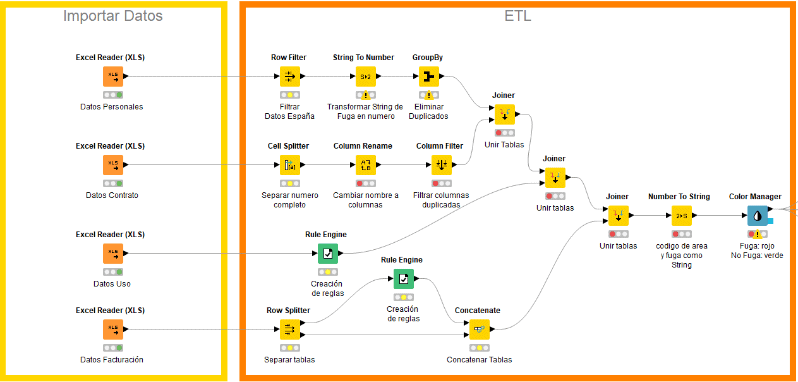
Kurz gesagt: Mit KNIME können wir alle Prozesse entlang der sieben Punkte der CRISP-DM-Methodik umsetzen, die wir im Folgenden anhand eines realen Projekts betrachten:
Geschäftsverständnis
Das übergeordnete Ziel dieser Phase ist es, die Projektziele und -anforderungen aus geschäftlicher Perspektive zu verstehen und dieses Wissen in die Definition eines Data-Mining-Problems sowie in einen vorläufigen Plan zur Zielerreichung zu überführen.
Wir gehen von einem Unternehmen aus der Telekommunikationsbranche aus, dessen Vertragsmodell für Kunden keine Mindestlaufzeit erfordert. Gleichzeitig ist die Kundenfluktuation sehr hoch, mit vielen Zu- und Abgängen jeden Monat. Ziel dieses Projekts ist die Kundenbindung mithilfe prädiktiver Algorithmen zur Kundenabwanderung.
Datenverständnis
In dieser Phase besteht das Hauptziel darin, die zu analysierenden Daten zunächst zu erfassen, um sich mit ihnen vertraut zu machen, Qualitätsprobleme zu identifizieren, interessante Teilmengen zu erkennen, um spezifische Hypothesen zu formulieren, die später durch Analysen validiert werden, und sogar erste Erkenntnisschlüssel zu identifizieren, die aus den Daten gewonnen werden können.
Für diesen Fall stehen folgende Daten zur Verfügung:
- Personendaten mit markierter Abwanderung (ERP-System)
- Vertragsdaten (ERP-System)
- Nutzungsdaten (System zur Nutzungsüberwachung)
- Abrechnungsdaten (Abrechnungssystem)
Datenaufbereitung
Sobald die Daten ausgewählt sind, folgt die Phase der Datenaufbereitung. Die Datenaufbereitung, oft auch „Preprocessing“ genannt, ist die Phase, in der Rohdaten bereinigt und für den nächsten Verarbeitungsschritt strukturiert werden. Während der Aufbereitung werden die Rohdaten auf Fehler geprüft. Ziel dieses Schritts ist es, fehlerhafte Daten (redundante, unvollständige oder falsche Daten) zu entfernen und mit dem Aufbau qualitativ hochwertiger Daten zu beginnen.
Für die Aufbereitung ermöglicht KNIME die Integration mehrerer Datenquellen (SQL-Datenbanken, Excel, CSV, Webservices/APIs)
- Daten aus ERP-, Monitoring- und Abrechnungssystemen
Außerdem bietet es zahlreiche Funktionen zur Datentransformation:
- Nach Land filtern, nach Kunde gruppieren, Duplikate entfernen, Berechnungen und zusätzliche Felder usw.
Zur Arbeitserleichterung stehen visuelle und intuitive Workflows zur Verfügung:
- Drag&Drop von Funktionen, sichtbare Verbindungen usw.
Modellierung
Datenmodellierung ist eine Methode, Daten zu strukturieren und zu organisieren, damit sie von Datenbanken leicht genutzt werden können. Sie wird üblicherweise in Kombination mit einem Datenbankmanagementsystem eingesetzt. Die für dieses System modellierten und aufbereiteten Daten lassen sich auf verschiedene Weise identifizieren, z. B. danach, was sie darstellen oder wie sie mit anderen Daten zusammenhängen. In KNIME steht uns eine umfangreiche Bibliothek für Advanced Analytics zur Verfügung:
- Klassifikationsalgorithmen (Abwanderung Ja/Nein) zur Vorhersage der Kundenabwanderung
Bewertung
In diesem Schritt wird bewertet, inwieweit das Modell die Geschäftsziele erfüllt, und es wird festgestellt, ob es geschäftliche Entscheidungen gibt, die das Modell nicht abdeckt. Eine weitere Evaluationsmöglichkeit ist das Testen des Modells anhand von Testszenarien. Die Bewertung überprüft außerdem weitere Ergebnisse, die durch Data Mining erzeugt wurden.
Ziel ist es, die Evaluationsergebnisse anhand von geschäftlichen Erfolgskriterien zusammenzufassen, einschließlich einer abschließenden Aussage dazu, ob das Projekt die ursprünglichen Geschäftsziele erreicht hat.
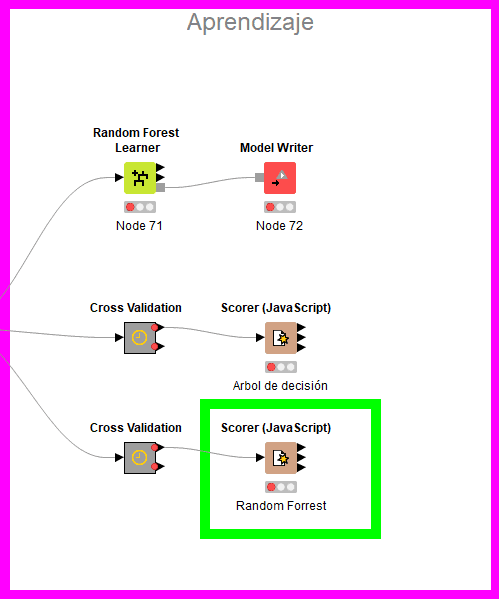
Bewertung und Vergleich von Algorithmen mittels Cross-Validation:
- Wir trainieren Random Forest und Entscheidungsbaum mit 80 % der Daten und wenden sie auf die verbleibenden 20 % an, um die Ergebnisse zu überprüfen.
Auswahl des Algorithmus und Export des trainierten Modells
- Random Forest erzielt mit 93 % Trefferquote die höchste Zuverlässigkeit, daher wählen wir dieses Verfahren.
Deployment
Die Erstellung des Modells und seine positive Bewertung bedeuten nicht das Ende des Projekts. Das durch den Data-Mining-Prozess gewonnene Wissen muss organisiert und so präsentiert werden, dass es im geschäftlichen Kontext nutzbar ist. Dies umfasst die Integration der Modelle in die Entscheidungsprozesse der Organisation und erfordert zudem die Einbindung des Kunden in die Schritte zur Inbetriebnahme des Modells.
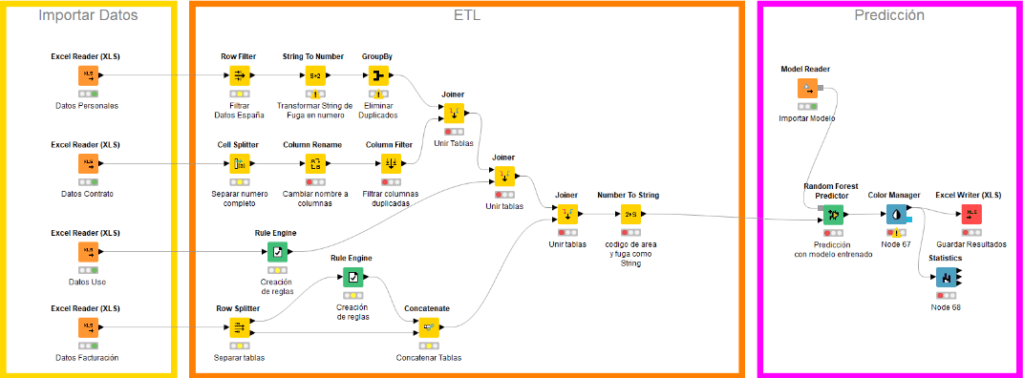
Workflow für die Vorhersage:
- Der Workflow verbindet sich mit den Datenquellen und extrahiert die neuesten Daten, um künftig die Kunden vorherzusagen, die ihren Vertrag beenden werden.
Automatisierung des Workflows:
- Mit KNIME Server können Sie Ihren Workflow automatisieren; er kann bis zu mehrmals täglich ohne menschliches Zutun ausgeführt werden.
Integration der Ergebnisse in den Prozess:
- Das für die Kundenbindung verantwortliche Team erhält die Ergebnisse und steuert Bindungsmaßnahmen auf Kunden mit hoher Abwanderungswahrscheinlichkeit.
Reduzierung der Kundenabwanderung um bis zu 30 %
Visualisierung – Business Intelligence
Die Ergebnisse können in ein intuitives Business-Intelligence-Dashboard integriert werden. So kann das Kundenbindungsteam die Situation detailliert analysieren und eine wirkungsvolle Strategie ableiten, um die Abwanderung von Kunden zu verhindern.