
Entwurf einer Big-Data-Architektur für die Verarbeitung von Produktionsdaten
Einer der größten Fortschritte des letzten Jahrzehnts war die Entwicklung von Tools, die große Datenmengen verarbeiten können. Anfang der 2000er-Jahre begann Google, Methoden zur verteilten Verarbeitung und Speicherung von Daten zu erforschen, woraus ein verteiltes Dateisystem (GFS) und eine Verarbeitungsmethode namens MapReduce entstanden.
Von dort aus wurden – dank der Innovation zahlreicher Unternehmen, die ihre Methoden und Code-Repositories der Community zur Verfügung stellten – die Tools weiterentwickelt, die uns heute die Verarbeitung enormer und vielfältiger Datenquellen ermöglichen: „Big Data“.
Wenn wir von Big Data sprechen, meinen wir Massendaten, die durch Geräte oder einzelne Nutzeraktionen erzeugt werden können und – in Beziehung zueinander gesetzt – relevante Informationen über das Verhalten komplexer Systeme liefern.
Mit dem Aufkommen von IoT-Geräten, dem Internet der Dinge, ist es möglich, Daten von nahezu jeder Maschine zu erfassen. Im Logistik- und Produktionsumfeld lassen sich Daten von Maschinen, die industrielle Aufgaben ausführen, analysieren, um ihre Effizienz zu bestimmen, Ausfälle zu erkennen oder ihren Betrieb zu optimieren.
Ein effizientes Design einer Big-Data-Architektur in einem Produktionsumfeld wäre in der Lage, die folgenden Funktionen zu erfüllen:
- Echtzeit-Datenverarbeitung zur Bestimmung der Effizienz industrieller Prozesse
- Zusammenführung von Daten aus Batch-Prozessen (z. B. Daten aus einem ERP oder CRM) mit in Echtzeit erzeugten Daten zur Durchführung von Finanzanalysen
- Erstellung von Dashboards, die aktualisiert werden, während die Daten erzeugt und verarbeitet werden
- Analyse von Störungen, die es ermöglicht, auf Basis von durch IoT-Geräte erzeugten Daten Pläne für vorausschauende Wartung zu erstellen
- Prozessoptimierung, z. B. Routenoptimierung oder Ressourcenumverteilung mit nahezu unmittelbaren Reaktionszeiten
- Trendanalysen und Erstellung von Empfehlungen auf Basis des laufenden Betriebs
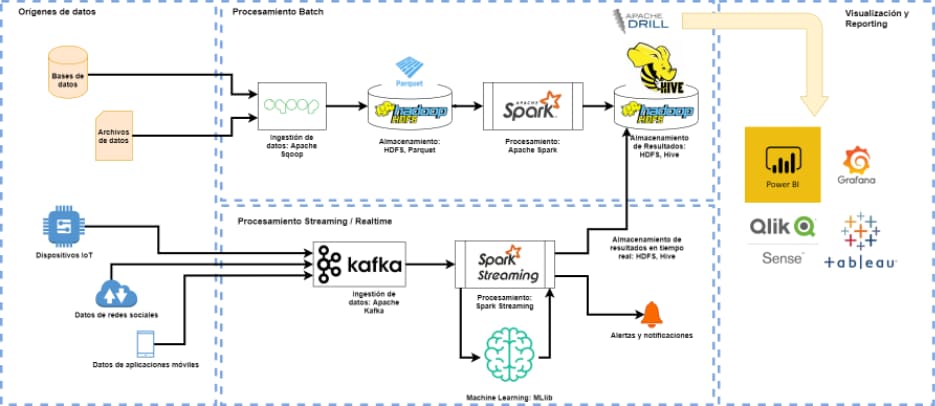
Die perfekte Architektur für Big Data
Eine perfekte und standardisierte Architektur gibt es nicht. Jedes Projekt, jeder Einzelfall, bestimmt die Eigenschaften der idealen Architektur. Um zu dieser idealen Architektur zu gelangen, ist es notwendig zu bewerten, welche und wie viele Geräte diese Daten liefern können oder durch Sensoren, die die für die Analyse erforderlichen Daten erfassen, intelligent gemacht werden können. Auf Basis dieser Daten wird – abhängig von der Häufigkeit der Datenerzeugung und den erforderlichen Korrelationen mit anderen Prozessen, wie z. B. Datenbanken mit Unternehmensinformationen – eine technologische Architektur erstellt, die mithilfe von Big-Data-Verarbeitungstools in der Lage ist, relevante Informationen für geschäftliche Entscheidungen zu liefern, die Effizienz der Produktionsprozesse zu verbessern und möglichen Störungen zuvorzukommen, die die Produktionskapazität verringern könnten.
Bei Baitech arbeiten wir mit führenden Datenverarbeitungstechnologien wie Kafka und Spark aus der Apache Hadoop-Suite sowie mit Visualisierungstechnologien für Dashboards wie Qlik Sense, Power BI und Grafana. Diese Technologien haben es uns ermöglicht, Datenverarbeitungssysteme zu realisieren, die unseren Kunden relevante Informationen über ihre Produktionsprozesse liefern und ihnen dabei helfen, die Funktionsweise ihres Unternehmens zu analysieren und zu optimieren.