
PCA-Algorithmus: Vom Komplexen zum Einfachen
Wenn man vor einer komplexen Situation steht, geht es immer darum, das Problem zu vereinfachen.
Der PCA-Algorithmus versucht, das ursprüngliche Problem zu vereinfachen, um es Schritt für Schritt vom Einfachsten zum Komplexesten lösen zu können. Dabei wird gleichzeitig die nötige Erfahrung gesammelt, um das Ausgangsproblem zu bewältigen.
PCA, Reduzierung von Variablen
Ausgehend von einem Problem mit mehreren Variablen soll verstanden werden, welche Beziehung zwischen ihnen besteht. Dazu wird im ersten Schritt die Anzahl der vorhandenen Variablen so weit wie möglich reduziert. Ist dieser Schritt abgeschlossen, stellen wir das Ergebnis visuell dar und können so einfach und intuitiv erkennen, wie sich die Daten gruppieren.
Es liegt eine CSV-Datei vor, die den Verlauf von Bestellungen für bestimmte Teile speichert. Ziel dieser Datenanalyse ist es, die Teile, die sich aufgrund ihrer Eigenschaften ähneln, zu gruppieren, also diejenigen zu identifizieren, die im Raum nahe beieinanderliegen. Dies in einem 12-dimensionalen Raum zu tun, ist weder einfach noch grafisch darstellbar. Deshalb wird angestrebt, die Anzahl der Variablen auf ein Minimum zu reduzieren. Um diese Umwandlung durchzuführen, wird eine mathematische Technik verwendet, die als „Hauptkomponentenanalyse“ bekannt ist.
Was ist eine „Hauptkomponentenanalyse“ oder PCA? Und wozu dient sie?
Es handelt sich um ein mathematisches Verfahren, mit dem die Anzahl der Variablen reduziert wird, sodass wir am Ende eine minimale Anzahl neuer Variablen erhalten, die alle ursprünglichen Variablen möglichst repräsentativ abbilden. Das heißt, wenn die Anzahl der Variablen auf zwei oder drei neue reduziert wird, können die Originaldaten in der Ebene oder in einem 3-dimensionalen Diagramm dargestellt werden, wodurch eine grafische Zusammenfassung unserer Daten entsteht. Allein die Tatsache, die Daten visuell sichtbar zu machen, vereinfacht das Verständnis dessen, was vor sich geht, erheblich und erleichtert die Entscheidungsfindung.
Im Folgenden wird die Analyse der Bestellungen durchgeführt. Auf die rein mathematischen Details wird aufgrund ihrer Komplexität nicht eingegangen.
Der erste Schritt besteht darin, anhand der folgenden Grafik zu beobachten, wie viele Hauptkomponenten wir auswählen sollten.
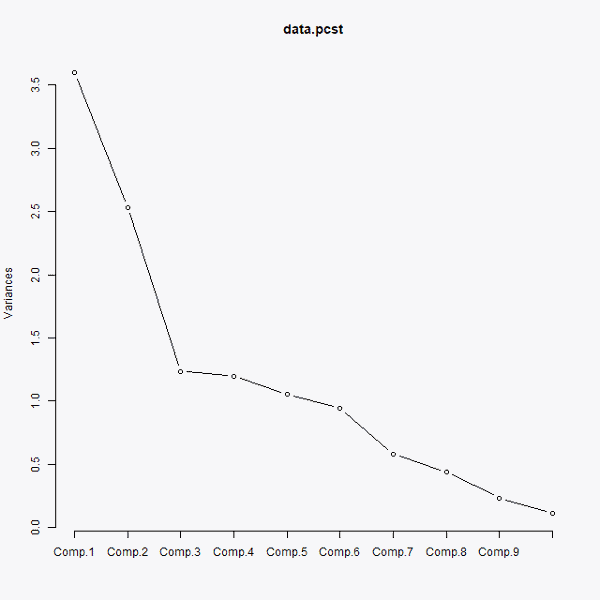
Auswahl der Anzahl der Hauptkomponenten
Wie in der vorherigen Grafik zu sehen ist, vereinen die ersten drei Komponenten die größte Varianz, weshalb wir sagen können, dass sie die wichtigsten Hauptkomponenten für die Analyse sind. Um die Ergebnisse im Verlauf dieses Beitrags jedoch zweidimensional darstellen zu können, wählen wir nur die ersten beiden aus. In der folgenden Grafik können wir sehen, welchen Einfluss jede Variable auf die neuen Hauptkomponenten ausübt:
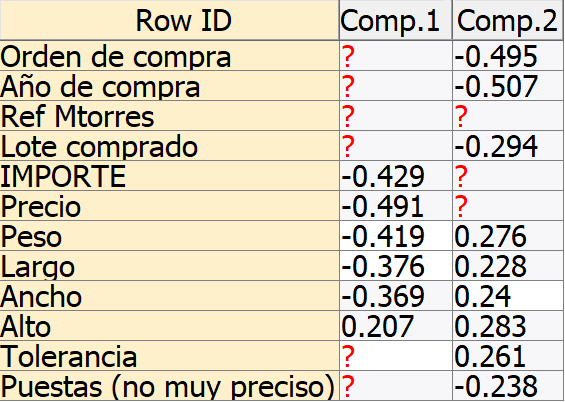
Einfluss jeder Variable auf die beiden Hauptkomponenten
Wie wir sehen können, üben die Variablen mit dem größten Gewicht auf die erste Hauptkomponente die Maße der Teile aus, während die Variablen mit dem größten Gewicht auf die zweite Hauptkomponente die übrigen Variablen sind, wobei das Jahr des Kaufs und die Bestellnummer den größten Einfluss haben. Man könnte sagen, dass die erste Hauptkomponente die Eigenschaften der gekauften Teile darstellt, während die zweite Hauptkomponente die Merkmale des Kaufs selbst darstellt.
Sobald bekannt ist, was jede der Variablen darstellt, werden sie zweidimensional dargestellt. Auf der „x“-Achse wird die erste Hauptkomponente und auf der „y“-Achse die zweite Hauptkomponente abgebildet. So erhält man Grafik 3. Darin lässt sich die Darstellung der Ausgangsdaten in zwei Dimensionen erkennen.
Auf diese Weise lässt sich jede der Bestellungen interpretieren. Man kann erkennen, dass Bestellung Nummer 46 (oben links in Grafik 3), ebenso wie Bestellung 108 (oben rechts), als Ausreißer betrachtet werden könnten. Was an dieser Grafik jedoch zweifellos am meisten auffällt, ist, dass mehr als 80 % der Daten in zwei Gruppen konzentriert sind, die durch zwei rote Kreise hervorgehoben werden. Dies zeigt uns, dass die Bestellungen, die sich nicht in der Nähe dieser Gruppen befinden, diejenigen sind, die eine größere Varianz beim Preis der Bestellungen verursachen. Je weiter rechts sich eine Bestellung befindet, desto teurer muss sie sein, und je weiter links sie sich befindet, desto günstiger muss sie sein. Dies leiten wir aus Grafik 2 und dem Einfluss der einzelnen Variablen auf die Hauptkomponenten ab.
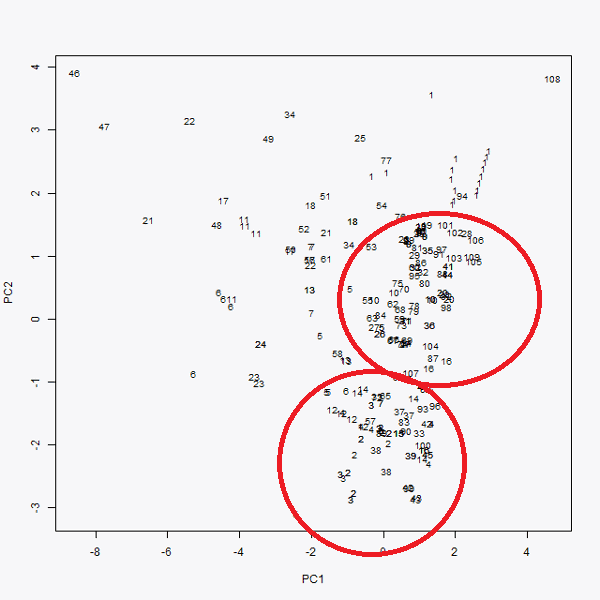
Grafische Darstellung in den beiden Hauptkomponenten
Klassifizierung der Daten mithilfe des K-Means-Algorithmus
Nach dieser grafischen Darstellung verwenden wir nun den K-Means-Algorithmus. Dieser Algorithmus dient dazu, Gruppen innerhalb einer „Punktwolke“ zu lokalisieren, die in diesem Fall die Bestellungen darstellen. Es wurde beschlossen, die Daten in drei Gruppen einzuteilen, daher wird der K-Means-Algorithmus mit K=3 durchgeführt. Das erzielte Ergebnis ist folgendes:
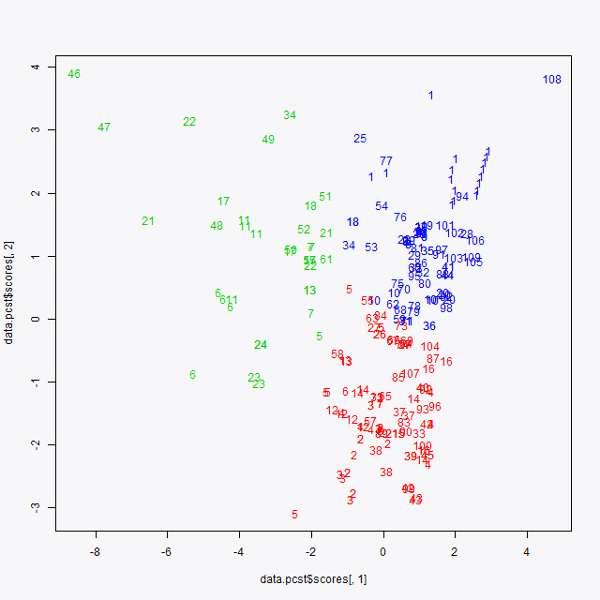
K-Means-Grafik
Man erhält demnach drei Gruppen. Wie bereits erwähnt, gab es zwei klar unterscheidbare Gruppen (jetzt rot und blau dargestellt), und wir finden eine dritte Gruppe, die aus den übrigen Punkten besteht, die alle Daten darstellen, die aus den beiden zuvor erwähnten Bestellgruppen „herausfallen“.
Um die Analyse fortzusetzen und tiefere, wichtigere Schlussfolgerungen zu ziehen, müsste eine eingehende Analyse der Daten der dritten, in Grün dargestellten Gruppe durchgeführt werden.
Fazit
Wenn wir auf eine Vielzahl von zu analysierenden Variablen stoßen, ist es am besten, diese Variablen auf ein Minimum zu reduzieren, um sie grafisch und intuitiv darstellen zu können. Ist dieser Schritt erfolgt, können weitere Techniken angewendet werden, die, wie in diesem Fall, dazu dienen, noch klarer und deutlicher zu verstehen, wofür die Daten verwendet werden können oder wie sie zu interpretieren sind.
Diese Art der Datenanalyse ist sehr nützlich, um Variablen miteinander in Beziehung zu setzen und zu verstehen, wie sie zusammenhängen. Angewendet auf die Logistik kann diese Studie beispielsweise auch dazu dienen, zu entscheiden, an welchem geografischen Standort sich ein Lager am besten errichten lässt. Betrachten wir die Punkte des letzten Bildes als Endkunden und planen den Bau von drei Lagern, von denen aus die Produkte eines Unternehmens verteilt werden sollen, können wir feststellen, dass der optimale Standort für die Lager jeweils im Zentrum dieser Gruppen liegt, sodass die Entfernung vom Lager zu den Kunden minimal ist.
Auf Facebook teilen
Auf Google teilen
Auf Twitter teilen
Auf LinkedIn teilen
Auf Pinterest teilen
Drucken
Per E-Mail teilen