
Automatisierung der Bedarfsprognose
Automatisierte Bedarfsprognose
Wie viel Material müssen wir in den nächsten Wochen einkaufen? Wann werden wir ein bestimmtes Produkt produzieren müssen? Verfügen wir über ausreichende Kapazitäten, um die Nachfrage zu decken? Dies sind einige der Fragen, auf die Unternehmen täglich eine Antwort suchen. Die Bedarfsprognose für Ihre Produkte ist für eine effiziente Planung innerhalb des Unternehmens unerlässlich und kann die optimale Lösung für diese Fragen liefern. Häufig gibt es Hunderte von Produkten, für die mindestens monatlich die Nachfrage ermittelt werden muss. Selbst wenn eine geringere Anzahl an Prognosen erforderlich ist, verfügt möglicherweise niemand über ausreichende Kenntnisse im Umgang mit Prognosemodellen. In diesen Fällen kann ein automatischer Prognosealgorithmus ein sehr wertvolles Werkzeug sein.
Die Prognosealgorithmen
Generell gibt es zwei Arten von Prognosemethoden: qualitative und quantitative Methoden. Während qualitative Methoden, wie beispielsweise die Delphi-Methode, auf dem Wissen und der Einschätzung von Experten beruhen, nutzen quantitative Methoden historische Daten innerhalb mathematischer Modelle, um Prognosen zu erstellen. Bei einem neuen Produkt, zu dem keine Daten vorliegen, oder bei strategischen Projekten, bei denen viele Faktoren von Bedeutung sind, können qualitative Methoden bessere Ergebnisse liefern. Mit der zunehmenden Verfügbarkeit von Daten und wachsenden Rechenkapazitäten werden quantitative Methoden jedoch immer gebräuchlicher. Zudem können diese Methoden automatisiert werden und sind nicht auf Expertenwissen angewiesen. Daher werden wir im Folgenden einige quantitative Methoden im Detail beschreiben.
Prognosen sind ein Forschungsgebiet mit langer Tradition, und es wurde eine Vielzahl von Modellen und Algorithmen entwickelt. Da sich die Nachfrage von Produkt zu Produkt jedoch stark unterscheidet, gibt es kein Modell, das für die Prognose aller Produkte perfekt geeignet ist. Daher setzen wir bei Baitech verschiedene Prognosealgorithmen ein, um die Prognosequalität sicherzustellen. Die Methoden lassen sich in folgende Familien einteilen:
- Naive Methoden.
- Exponential-Smoothing-Methoden.
- ARIMA-Methoden.
- Weitere Methoden.
Alle diese Methoden basieren ausschließlich auf dem historischen Bedarfsverlauf zur Berechnung der Prognose. Ihre Anpassung für jedes Produkt kann automatisiert werden, weshalb sie sich ideal für die Automatisierung von Prognosen eignen.
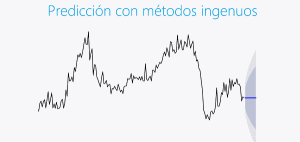
Die naiven Methoden sind sehr einfach und nutzen historische Werte zur Prognose. Eine dieser Methoden ist die einfache naive Methode, bei der die Prognose dem letzten beobachteten Wert entspricht. Eine weitere Methode ist die saisonale naive Methode, die den Wert derselben Jahreszeit des Vorjahres als Prognose verwendet. Auch wenn diese Methoden oft nicht sehr präzise sind, gibt es Situationen, in denen ihr Einsatz angemessen sein kann. Sie werden beispielsweise häufig im Finanzsektor eingesetzt.
Die Exponential-Smoothing-Methoden basieren auf dem Komponentenmodell von Zeitreihen. Bei diesem Modell wird die Zeitreihe in Trend, Saisonkomponenten und eine Fehlerkomponente zerlegt, die zur Erstellung der Prognose extrapoliert werden. Mithilfe von Rekursionsformeln, bei denen der letzte Wert mit einem gleitenden Durchschnitt der historischen Werte kombiniert wird, werden die zukünftigen Werte berechnet. Diese Methoden sind sehr verbreitet und eignen sich besonders für die Prognose von Bedarfen, die durch klare Trends und Saisonalitäten geprägt sind.
Prophet ist ein Algorithmus, der auf denselben Grundgedanken basiert. Er wurde von Ingenieuren bei Facebook entwickelt. Ebenso wie bei den Exponential-Smoothing-Methoden wird die Zeitreihe in Komponenten zerlegt, wobei zusätzlich der Einfluss von Feiertagen und Saisonalitäten auf mehreren zeitlichen Ebenen berücksichtigt werden kann. Die einzelnen Komponenten werden mithilfe unterschiedlicher Funktionen modelliert (logistisches Wachstum, Fourier-Reihen, Autoregressionen). Dieser Algorithmus kann Bedarfe mit überlagerten saisonalen Mustern vorhersagen, also Muster, die sich gegenseitig überschneiden, sowie Trends auf stündlicher Ebene (z. B. Prognose von Website-Besuchen), auf Tages- oder Wochenebene.
Ebenso wie die Exponential-Smoothing-Methoden haben ARIMA-Modelle eine lange Tradition in der Prognose von Zeitreihen und Bedarfen. Diese Modelle kombinieren Autoregressionsmodelle (AR) und gleitende Durchschnitte (MA) mit integrierten Daten (I). Die Autoregressionsmodelle stellen eine lineare Kombination der kurzfristig zurückliegenden Werte dar. Bei den Modellen der gleitenden Durchschnitte werden vergangene Zufallsfaktoren kombiniert. Damit das Modell korrekt funktioniert, müssen die Daten stationär sein. Um mögliche Trends oder Saisonalitäten zu entfernen, werden die Daten integriert. Diese Faktoren werden am Ende der Berechnung wieder hinzugefügt. ARIMA-Modelle eignen sich für Zeitreihen, bei denen der Einfluss kurzfristig zurückliegender Werte von Bedeutung ist.
Mit diesen unterschiedlichen Methodentypen lassen sich alle Arten von Bedarfen auf täglicher, monatlicher oder jährlicher Ebene prognostizieren. Durch die Automatisierung der Algorithmen können diese Prognosen regelmäßig ohne manuellen Eingriff berechnet werden.
Auswahl der optimalen Methode
Alle diese Methoden haben ihre Stärken und Schwächen. Die alleinige Verwendung eines dieser Algorithmen würde nicht zu einem zufriedenstellenden Ergebnis führen. Also: Wann sollten wir welche Methode verwenden? Diese Frage lässt sich manchmal durch die Betrachtung der Zeitreihe der Nachfrage und ihrer Merkmale beantworten. Dies ist jedoch unmöglich, wenn Tausende von Prognosen benötigt werden. Für diese Fälle können wir ein Klassifikationsmodell erstellen, das mit Machine-Learning-Algorithmen entwickelt wird. Die Machine-Learning-Algorithmen (z. B. Support Vector Machine oder Entscheidungsbäume) werden mit historischen Metadaten gespeist, die zum einen die Merkmale der Zeitreihe (Trendstärke, Saisonalität, Autokorrelation, Entropie usw.) und zum anderen die optimale Methode für jede Zeitreihe enthalten. Die Machine-Learning-Algorithmen erkennen Zusammenhänge zwischen den Merkmalen der Zeitreihe und der optimalen Methode und erstellen so ein Klassifikationsmodell. Dieses Klassifikationsmodell kann auf jede beliebige Zeitreihe und ihre Merkmale angewendet werden, um die für die Prognose zu verwendende Methode zu ermitteln.
Bewertung der Prognosen
Durch den Einsatz mehrerer Prognosemethoden und die stets passende Auswahl gelingt es uns, die Prognosen zu optimieren und ihren Fehler zu minimieren. Dennoch ist es nicht möglich, den Fehler vollständig zu eliminieren. Aus diesem Grund ist es wichtig, den Prognosefehler zu berechnen, damit der Nutzer die Prognose und ihre Zuverlässigkeit bewerten kann. Mithilfe einer Kreuzvalidierung der gewählten Prognosemethode können wir den zukünftigen Prognosefehler abschätzen. Zur Berechnung des Prognosefehlers werden Testprognosen innerhalb der historischen Daten erstellt. Diese Testprognosen werden mit den verfügbaren Daten verglichen, um den geschätzten Fehler der tatsächlichen Prognose zu berechnen.
Durch die Festlegung von Grenzwerten für den Prognosefehler lässt sich beurteilen, ob die Prognose zuverlässig ist oder nicht. Zusätzlich berechnen die Prognosealgorithmen Konfidenzbereiche, die ebenfalls die Zuverlässigkeit der Prognose widerspiegeln.
Bei Baitech entwickeln wir automatisierte Systeme mit verschiedenen Prognosemethoden, die regelmäßig die Nachfrage für Tausende von Produkten vorhersagen können, den Prognosefehler auf ein Minimum reduzieren und dessen Zuverlässigkeit transparent kommunizieren. Mit diesen Informationen können wir feststellen, wann wir produzieren müssen, welches Produkt und wie viel Material wir einkaufen sollten. Letztlich optimieren wir die Planung, steigern die Effizienz und senken die Kosten.
Für weitere Informationen kontaktieren Sie uns unter info@lisdatasolutions.com