
Deep Learning, neuronale Netze und Computer Vision
Lernen ist eine dem Menschen inhärente Eigenschaft. Von Geburt an sammeln wir Informationen und speichern sie, um die Aufgaben des täglichen Lebens bewältigen zu können. Dieser Prozess, der uns – den sicherlich fälschlicherweise so genannten rationalen Tieren – eigen ist, ist nicht mehr exklusiv uns vorbehalten. Maschinen sind in der Lage zu lernen, oder besser gesagt, wir sind in der Lage, sie lernen zu lassen.
Dank der Entwicklung der Künstlichen Intelligenz (KI) ist es uns gelungen, dass Computer bestimmte menschliche Funktionen imitieren. Doch dabei bleibt es nicht: Wie bereits erwähnt, wurde ein weiterer Schritt getan – und zwar kein gewöhnlicher, sondern ein quantitativer –, indem man erreicht hat, dass Maschinen Aktionen nicht nur ausführen, sondern sie erlernen und ihre eigene Leistung verbessern.
Dieser Selbsterziehungsprozess wird durch die Implementierung von Systemen des Machine Learning oder maschinellen Lernens erreicht, einem Zweig der KI, der auf die Entwicklung von Algorithmen ausgerichtet ist, die menschliche kognitive Funktionen imitieren. Innerhalb dieser Technik wurde wiederum das Deep Learning entwickelt, das mit dem Konzept von Maschen arbeitet und künstliche neuronale Netze erzeugt, die die Funktionsweise biologischer neuronaler Netze und folglich die Arbeitsweise des komplexen menschlichen Gehirns simulieren.
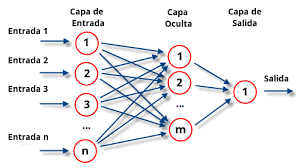
Wie der Name schon sagt, leitet sich Deep Learning (tiefes Lernen) von der Verwendung verborgener Schichten in der Zusammensetzung neuronaler Netze ab. Diese verfügen über eine Eingabeschicht oder Datenquelle, die das System speist, eine Vielzahl von Zwischenschichten, deren verarbeitete Werte uns nicht bekannt sind, und eine Ausgabeschicht, die das Ergebnis der vom Netzwerk durchgeführten Datenverarbeitung anzeigt. Um die Parallele zwischen Mensch und Maschine fortzuführen: Das genannte digitale Verfahren entspricht einem ähnlichen Ablauf wie dem, wenn uns beispielsweise ein Ball zugeworfen wird: Unsere Augen erfassen das Bild eines sich bewegenden Objekts (Eingabequelle), das Gehirn verarbeitet die empfangenen Informationen: Größe, Geschwindigkeit, geschätztes Gewicht, Farbe, Material… (verborgene Schichten), und mit diesen verarbeiteten Daten geben wir eine Antwort auf den ursprünglichen Reiz (Ausgabeschicht).
Innerhalb der vielfältigen Potenziale dieses komplexen und umfassenden Systems zeichnet sich Deep Learning durch Prozesse der Analyse, Erkennung und Klassifizierung von Bildern auf der Grundlage eines trainierten Modells (Computer Vision) aus. Diese Eigenschaft wird immer nützlicher, wenn man bedenkt, dass grafische Informationen dank der Verbilligung und Verbreitung von Technologie allgegenwärtig geworden sind. Heutzutage verfügen wir über eine große Auswahl an Aufnahmen, viele davon in Echtzeit, die von Kameras (fest installiert oder mobil, terrestrisch oder aus der Luft), Ultraschall, Funkfrequenz oder Satelliten erfasst werden. Dies ermöglicht unzählige Anwendungen in sehr unterschiedlichen Bereichen wie der Instandhaltung von Anlagen, dem autonomen Fahren von Fahrzeugen, der Optimierung von Flotten und Lagern, der medizinischen Diagnose oder der Oberflächenanalyse (Anbauflächen, Katastrophen, Ingenieurwesen…), unter vielen anderen.
Convolutional Neural Networks
Bei der Entwicklung der Fähigkeit von Computern zu „sehen“ – sei es durch die Bestimmung dessen, was ein Bild als Ganzes darstellt (Klassifizierung), oder durch das Erkennen eines Objekts, das Teil davon ist (zum Beispiel die Kontrolle der Maskenpflicht in der aktuellen COVID-Krise) – sind Convolutional Neural Networks (CNN) besonders geeignet, da sie Informationen im Gegensatz zu herkömmlichen neuronalen Netzen und anderen Bildklassifizierungsalgorithmen schnell und einfach verarbeiten.
Ihr Arbeitssystem basiert auf der Lokalisierung von Mustern in kleinen Bereichen des Bildes und nicht im gesamten Bild. Dazu nimmt der Algorithmus ein kleines Quadrat aus Pixeln (Eingabe), das verschiedene verborgene Schichten durchläuft, die für eine schrittweise analytische Ausführung organisiert sind. Das heißt, die ersten Schichten des Netzwerks erkennen einfache Merkmale wie Linien, Kurven, Kanten…, während die tieferen Schichten in der Lage sind, komplexe Formen wie Personen, Fahrzeuge oder Tiere zu erkennen. Folglich gilt: Je größer die Anzahl der Schichten, desto besser ist die „Sehfähigkeit des Netzwerks“ und desto genauer ist seine Ausgabe, die uns als Ergebnis der Analyse die Wahrscheinlichkeit anzeigt, dass ein Bild zu einer vordefinierten Kategorie gehört, für deren Erkennung das Netzwerk trainiert wurde.
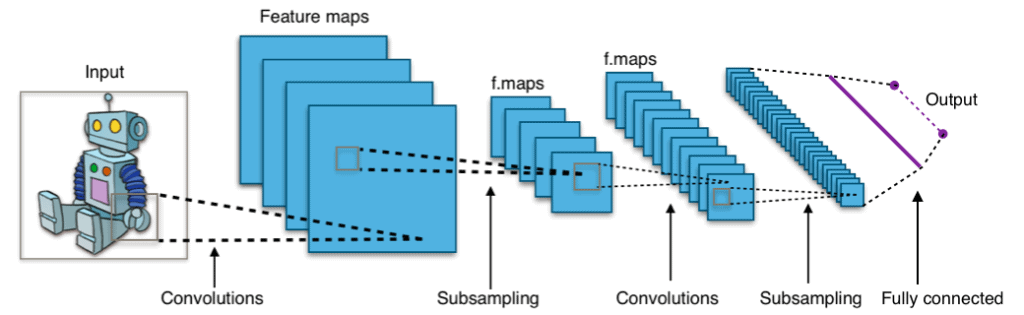
Das Interessanteste am gesamten Prozess ist, dass das Netzwerk in jeder Schicht die verschiedenen Merkmale des Bildes miteinander verknüpft und diese Informationen nutzt, um zu lernen und seine Erkennungsfähigkeit zu verbessern, bis es, wie erwähnt, in den letzten Schritten hochkomplexe Formen identifiziert. Ausgehend von dieser Selbstversorgung kann ein autonomer Mechanismus erreicht werden, indem das neuronale Netz mit einem breiten Spektrum an Bildern trainiert wird, die es zur Generierung seines eigenen Gedächtnisses nutzt. Nach dieser Phase ist das Deep-Learning-Modell bereit, mit neuen Bildern konfrontiert zu werden, die keiner vorherigen Klassifizierung unterliegen.
Von der Theorie zur Praxis
Wie bereits erwähnt, hat Computer Vision unzählige Anwendungen, die zudem täglich in dem Maße zunehmen, wie sich die neuen Technologien zur Bilderkennung entwickeln. Um die Theorie in die Praxis umzusetzen, werden wir Beispiele für Arbeiten vorstellen, die wir bei Baitech im Rahmen von Deep Learning angewandt auf visuelle Lösungen durchgeführt haben.
STANDORTBESTIMMUNG VON ANLAGEN
Ein internationaler Logistikdienstleister trat mit der Notwendigkeit an uns heran, die besten Standorte und Einrichtungen in bestimmten Gebietsradien zu lokalisieren, um Lagerhäuser in der Nähe seiner Massenverteilungsgebiete zu erwerben. Nach Analyse der Anforderungen entwickelten wir eine Suchlösung mit Quadratizitätsalgorithmen über Satellitenbilder, die wir mit Katasterdaten zur Identifizierung von Grundstücken und Gebäuden verknüpften. Diese wurden basierend auf ihrem Kaufpotenzial nach einer Kombination von Parametern wie Größe, Geometrie, Symmetrie, Lage und Preis pro m² klassifiziert. Zudem erstellten wir ein Convolutional Neural Network, das in der Lage war, die Bilder nach Boden- und Gebäudetyp zu klassifizieren.
AUTOMATISCHE SEGMENTIERUNG VON TUMOREN
Eine völlig andere Herausforderung, die ebenfalls mit Deep Learning gelöst wurde, wurde uns von einer akademischen Einrichtung gestellt: die Implementierung von Algorithmen zur automatischen Segmentierung von Tumoren in MRT-Bildern, um die Prozesse der Primäridentifikation und Entscheidungsfindung zu beschleunigen.
Und wir machten uns an die Arbeit. In diesem Fall entwarfen wir ein Modell zur automatischen Segmentierung von hochgradigen Gliomen (HGG), dessen Architektur auf dem Einsatz symmetrischer Convolutional Neural Networks basiert. Die Ergebnisse bei der Erstellung binärer Segmentierungskarten der Tumoren waren sehr positiv, mit einer guten Leistung bei der räumlichen Lokalisierung.
INSTANDHALTUNG GROSSER INFRASTRUKTUREN
Derzeit arbeiten wir an einem Projekt, das darauf ausgerichtet ist, die Überwachungs- und Wartungsprobleme einer großen Industrieinfrastruktur zu lösen. Mithilfe von Satellitenbildern sowie Kameraaufnahmen generieren wir ein System zur Früherkennung von Anomalien, die das Ergebnis von Brüchen und Defekten sein oder zu diesen führen können.
In diesem Fall sind die neuronalen Netze darauf trainiert, spontane Formen und Objekte in den aufgenommenen Bildern zu lokalisieren und zu identifizieren. Anders ausgedrückt: Der Algorithmus erkennt alles, was sich an einem Ort befindet, an dem es nicht sein sollte; als Beispiele können Elemente wie Feuer oder Produktleckagen dienen.
ERKENNUNG VON PARKPLÄTZEN
Überträgt man die Potenziale der grafischen Verarbeitung mit Deep Learning auf den Alltag, ist eine mögliche Anwendung der Computer Vision die Erkennung von Parkplätzen. Diese Aufgabe kann auf der Straße sehr nützlich sein, ist es aber noch mehr in Einrichtungen, die der Lagerung von Fahrzeugen dienen, wie etwa in einem Hafen. In diesen Infrastrukturen agieren verschiedene Akteure gleichzeitig mit unterschiedlichen Volumina und Rotationen von Einheiten. Daher wäre es besonders vorteilhaft, im Voraus zu wissen, welche Plätze zu jedem Zeitpunkt frei sind, wann mehr Platz benötigt wird oder welche Bereiche für eine bestimmte Nutzung am besten geeignet sind.
In diesem Fall würden wir mithilfe eines Computer-Vision-Algorithmus die Flächen im Bild identifizieren und anschließend mittels eines Klassifikators das Vorhandensein oder Fehlen eines Fahrzeugs bestimmen.