
Wie lassen sich Verbräuche mit Machine-Learning-Algorithmen vorhersagen?
Anknüpfend an den Beitrag der letzten Woche, der als Einführung in die Algorithmen des Machine Learning diente, wird eine Verbrauchsprognose erstellt. Ausgehend von vergangenen Verbräuchen wird versucht, die zukünftigen vorherzusagen und zu prüfen, wie gut sich die Prognose an die Realität anpasst.
Dazu werden die verfügbaren Daten analysiert, was Saisonalität ist und wie sie sich auf Lernalgorithmen auswirkt, und schließlich die Auswahl des Algorithmus sowie dessen Programmierung in der Sprache R.
Machine Learning – Verbrauchsprognose
Das übergeordnete Ziel dieser Beitragsreihe ist es, zukünftigen Ereignissen zuvorzukommen und so die in einem Unternehmen benötigten Ressourcen zu antizipieren, um sowohl Spitzen als auch Täler im Verkauf abzufedern.
Welche Daten benötigen wir, um mithilfe von Machine-Learning-Algorithmen vorhersagen zu können?
Es liegen nach Monaten aggregierte Verkaufsdaten vor; die ältesten stammen aus Juni 2014 und die neuesten aus Januar 2017, sodass eine Prognose für 9 Monate erstellt werden soll. Zusätzlich liegen die realen Daten für die Monate Februar bis Oktober 2017 vor, um nach Erstellung der Prognose einen Vergleich mit deren Ergebnissen durchführen zu können.
Stationäre Reihen und Reihen mit Saisonalität
Die Analyse der vorliegenden Zeitreihe ist eine der Herausforderungen im Auswahlprozess des Prognosealgorithmus.
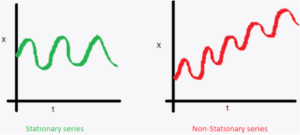
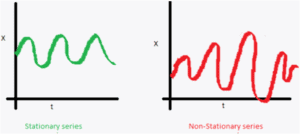
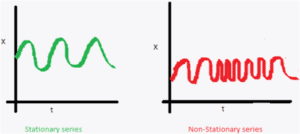
Als Erstes ist zu bestimmen, ob die Reihe stationär ist oder nicht (stationary series bzw. non-stationary series). Die große Mehrheit der Prognosealgorithmen ist darauf ausgelegt, Vorhersagen auf stationären Reihen zu erstellen; daher ist es sehr wichtig zu verstehen, wie eine stationäre Reihe aussieht. Wie in diesem Link zu sehen ist, lässt sich grafisch erkennen, ob unsere Reihe stationär ist oder nicht. Es gibt drei Kriterien, um zu klassifizieren, ob die Reihe stationär ist oder nicht:
- Der Mittelwert der Zeitreihe darf nicht von der Zeit abhängen, d. h. er muss konstant sein. Wie in der beigefügten Abbildung gezeigt, entspricht die grüne Kurve der stationären Kurve, bei der der Mittelwert konstant ist, während bei der roten Kurve zu erkennen ist, dass der Mittelwert mit der Zeit zunimmt.
- Die Varianz der Zeitreihe muss konstant sein, d. h. sie darf sich nicht in Abhängigkeit von der Zeit verändern. Wie im vorherigen Fall würde die grüne Kurve einer stationären Reihe entsprechen, im Gegensatz zur nicht stationären in Rot. In der ersten ist die Varianz konstant, während sie in der zweiten mit der Zeit variiert, da – wie zu sehen ist – der Unterschied zwischen Maxima und Minima im mittleren Bereich der roten Kurve größer ist.
- Das letzte Kriterium bezieht sich auf die Kovarianz zwischen einem Punkt „i“ der Zeitreihe und dem Punkt „(i+m)“. An diesen Punkten muss die Kovarianz über die Zeit konstant sein. Wie zu erkennen ist, erfüllt die rote Kurve diese Anforderung nicht, da sie sich je nach Zeit „zusammenzieht“ und „streckt“, während bei der grünen Kurve alle Maxima und Minima den gleichen Abstand haben.
Ein weiterer wichtiger Punkt bei der Anwendung eines Prognosealgorithmus ist zu wissen, ob die Reihe Saisonalität aufweist (seasonal series bzw. non-seasonal series). Das heißt, es ist wichtig, die Reihe zu desaisonalieren, um Phasen mit mehr oder weniger Verkäufen zu entfernen, wie etwa die Sommer- oder Wintersaison.
Nach der Analyse der in der ersten Grafik dargestellten Verbräuche ist leicht zu erkennen, dass diese Reihe nicht stationär ist und auch keine ausgeprägte Saisonalität hat; es wird lediglich im August und im Dezember weniger verkauft.
Der Algorithmus, der aufgrund der im vorherigen Prozess identifizierten Eigenschaften verwendet wird, befindet sich im Statistikprogramm R und ist die Funktion „auto.arima“. Diese Funktion in R arbeitet mit stationären und nicht stationären Reihen sowie mit Reihen mit oder ohne ausgeprägte Saisonalität.
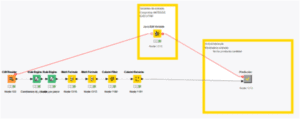
Abschließend wird Knime mit der Integration von R verwendet. Hier finden Sie einen weiteren Beitrag zu Knime und R. Nachfolgend wird ein Bild gezeigt, wie die grafische Oberfläche in Knime aussehen würde:
Arima als Prognosealgorithmus
Folglich ist für eine Verkaufsprognose, bei der nur vergangene Verkaufsdaten vorliegen, ein einfach zu verwendender Algorithmus der Arima-Algorithmus. Daher greift man – wie bereits erwähnt – zur R-Funktion „auto.arima“. Diese Funktion arbeitet sowohl mit stationären als auch mit nicht stationären Reihen und mit Reihen mit oder ohne ausgeprägte Saisonalität. Aus all diesen Gründen ist diese R-Funktion die gewählte, um diese Prognose zu erstellen.
Im nächsten Beitrag …
Im Beitrag der nächsten Woche werden die Ergebnisse grafisch dargestellt und die erstellte Prognose mit den realen Verbräuchen während der bewerteten Monate verglichen.